Skip to content
Volver al Blog
ai-architecture

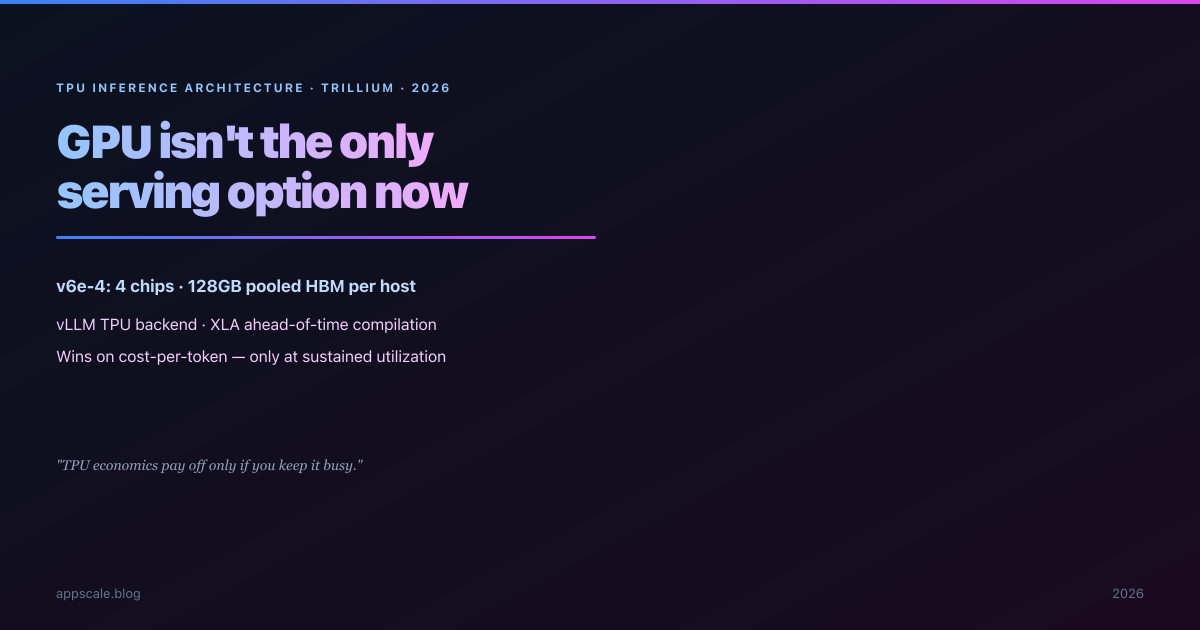
TPU Inference Architecture: Serving LLMs on Trillium with vLLM

By Satyam KumarJuly 1, 20268 min read
tpu inference trillium tpu tpu v6e vllm tpu backend google cloud tpu llm serving architecture xla compilation jax inference gpu vs tpu ai accelerators self-hosted llm continuous batching mcp infrastructure ops ai inference cost ai architecture patterns 2026
TPU Inference Architecture: Serving LLMs on Trillium with vLLM

Frequently Asked Questions

Compartir este artículo

Twitter LinkedIn WhatsApp

Satyam Kumar

Founder & AI Architect, AppScale LLP

Arquitecto de IA y Cloud. Ayudando a equipos a construir sistemas que escalan a millones.

Comments

Leave a comment