Back to Blogcyber-security-patterns 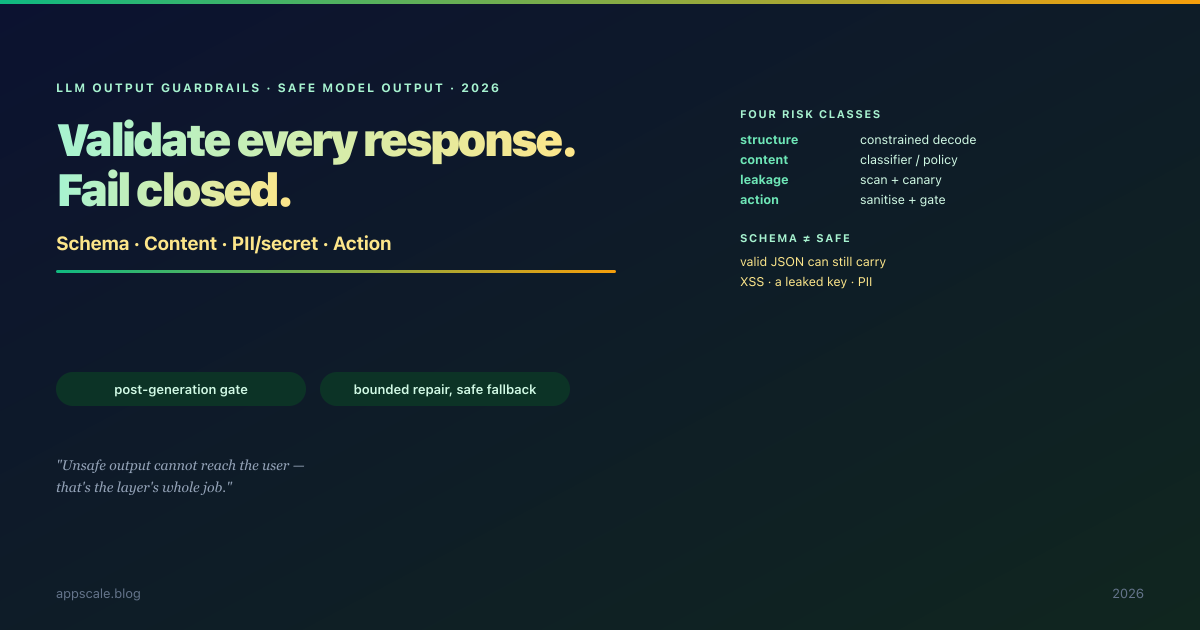
LLM Output Guardrails: An Architecture for Safe Model Output
llm output guardrails structured output constrained decoding jailbreak detection content moderation llm pii redaction llm security architecture improper output handling fail closed action gating nemo guardrails guardrails ai llama guard prompt leak canary ai red teaming cyber security patterns 2026